Black Friday, 20:15. Pagina de checkout a unui magazin online afișează, sub coș, un mic carusel: „Clienții care au cumpărat asta au mai cumpărat și…”. Recomandările vin de la un microserviciu separat, care chiar în seara asta a început să răspundă în 8 secunde în loc de 80 de milisecunde.
Echipa a făcut totul ca la carte: timeout de 3 secunde per încercare, 2 reîncercări cu jitter. Rezultatul: fiecare checkout așteaptă acum până la 9 secunde pentru un carusel pe care nimeni nu-l privește. Conexiunile către serviciul de recomandări se adună, pool-ul de conexiuni HTTP crește, memoria urcă. La 20:40, nici plățile nu mai trec, deși serviciul de plăți e perfect sănătos.
Retry-ul a făcut exact ce i s-a cerut: a insistat. Problema e că uneori cel mai inteligent lucru pe care îl poți face cu o dependență bolnavă este să nu o mai apelezi deloc o vreme, iar când totuși o apelezi, să nu-i permiți să consume resursele de care au nevoie restul funcționalităților. Asta fac cele două pattern-uri din acest articol: circuit breaker și bulkhead.
Circuit breaker: siguranța din tabloul electric
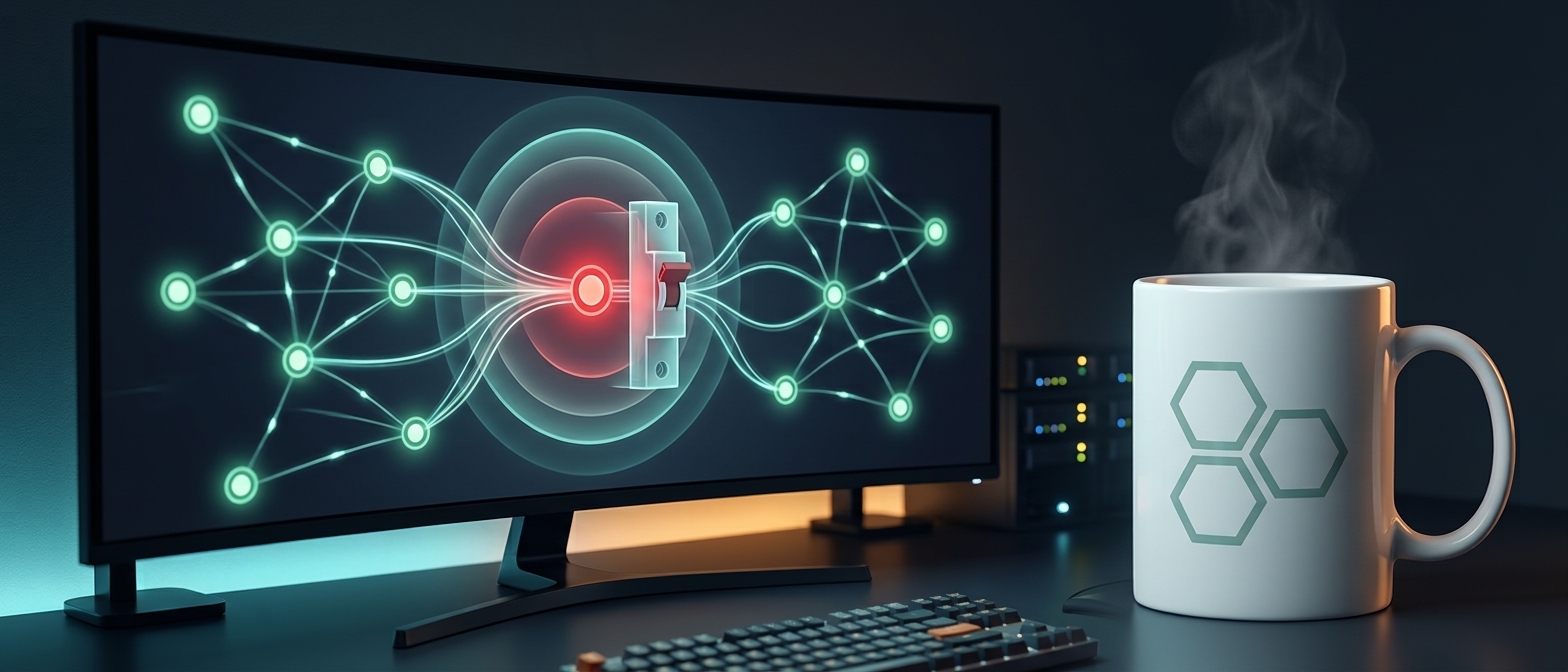
Analogia din nume e exactă. Siguranța automată din tabloul electric nu repară scurtcircuitul. Doar oprește curentul înainte ca firele să ia foc. Odată declanșată, nu mai trece curent prin circuitul respectiv, iar restul casei funcționează normal.
În software, circuit breaker-ul stă între codul tău și o dependență, urmărește rezultatul apelurilor și, când rata de eșec depășește un prag, „sare”. Din acel moment, toate apelurile către dependență eșuează imediat, fără să mai plece pe rețea. Două lucruri se întâmplă simultan:
- Aplicația ta se protejează. Un eșec instant costă microsecunde. Un timeout costă secunde, conexiuni și memorie. În loc să aștepți 9 secunde pentru o eroare pe care o știi deja, o primești imediat și treci la planul B.
- Dependența primește liniște. Un serviciu suprasolicitat are nevoie să scadă presiunea ca să-și revină. Retry-urile îi trimit mai mult trafic exact când nu poate să-l proceseze. Circuit breaker-ul îi taie traficul complet.
Retry-ul și circuit breaker-ul nu sunt alternative, ci se completează. Retry-ul tratează eșecurile scurte și izolate: o conexiune resetată, un 503 de o secundă. Circuit breaker-ul tratează eșecurile persistente și generalizate: o dependență care e jos de câteva minute.
Cele trei stări
- Closed — starea normală. Apelurile trec, iar breaker-ul numără succesele și eșecurile într-o fereastră de timp. Când rata de eșec depășește pragul, trece în Open.
- Open — circuitul e deschis. Niciun apel nu mai pleacă spre dependență. Toate eșuează imediat cu
BrokenCircuitException. Starea durează o perioadă configurată (break duration). - Half-Open — perioada de pauză a expirat. Breaker-ul lasă să treacă un singur apel de test, iar celelalte continuă să fie respinse. Dacă testul reușește, circuitul se închide și traficul revine la normal. Dacă eșuează, circuitul se redeschide pentru încă o perioadă.
Starea Half-Open e cea care face pattern-ul elegant. Breaker-ul nu are nevoie de un mecanism separat care să verifice dacă dependența și-a revenit: folosește chiar traficul real, dar în doze minime.
Circuit breaker în Polly v8
În Polly v8 există un singur tip de circuit breaker, bazat pe rata de eșec într-o fereastră de timp. Varianta din versiunile vechi, bazată pe un număr fix de eșecuri consecutive, a dispărut, iar motivul e bun: trei eșecuri consecutive înseamnă altceva la 5 cereri pe minut decât la 5.000 pe secundă.
builder.Services.AddResiliencePipeline<string, HttpResponseMessage>("recomandari", (pipeline, context) =>
{
    var logger = context.ServiceProvider
        .GetRequiredService<ILoggerFactory>()
        .CreateLogger("Resilience.Recomandari");

    pipeline.AddCircuitBreaker(new CircuitBreakerStrategyOptions<HttpResponseMessage>
    {
        FailureRatio = 0.5,
        MinimumThroughput = 10,
        SamplingDuration = TimeSpan.FromSeconds(30),
        BreakDuration = TimeSpan.FromSeconds(15),
        ShouldHandle = new PredicateBuilder<HttpResponseMessage>()
            .Handle<HttpRequestException>()
            .Handle<TimeoutRejectedException>()
            .HandleResult(r => (int)r.StatusCode >= 500),
        OnOpened = args =>
        {
            logger.LogError("Circuit deschis pentru {Duration}s", args.BreakDuration.TotalSeconds);
            return default;
        },
        OnClosed = _ =>
        {
            logger.LogInformation("Circuit închis, serviciul de recomandări și-a revenit");
            return default;
        }
    });
});
Configurarea de mai sus se citește așa: dacă, în ultimele 30 de secunde, au fost cel puțin 10 apeluri și cel puțin jumătate au eșuat, deschide circuitul pentru 15 secunde.
Cum alegi valorile
FailureRatio— pragul de eșec, între 0 și 1. Valoarea implicită, 0.1, e agresivă: circuitul sare la 10% erori. E potrivită pentru dependențe critice și stabile, unde 10% erori înseamnă deja o problemă reală. Pentru dependențe cunoscute ca instabile, un prag de 0.3–0.5 evită deschiderile inutile.MinimumThroughput— numărul minim de apeluri din fereastră înainte ca rata să conteze. Fără el, 1 eșec din 2 apeluri ar fi 50% și ar deschide circuitul. Atenție la reversul medaliei: dacă dependența are trafic mic, de exemplu 5 apeluri pe minut, iar pragul e 100 (valoarea implicită), circuitul nu se va deschide niciodată.SamplingDuration— fereastra de observație. Trebuie să fie de cel puțin două ori mai mare decât timeout-ul per încercare, altfel o fereastră nu apucă să vadă suficiente apeluri complete. Handler-ul standard validează această regulă la pornire.BreakDuration— cât rămâne circuitul deschis. Prea scurt și lovești din nou un serviciu care nu și-a revenit. Prea lung și rămâi degradat mai mult decât e nevoie. 15–30 de secunde e un punct de plecare rezonabil pentru majoritatea API-urilor.
Break duration adaptiv
Dacă circuitul se redeschide de mai multe ori la rând, dependența are clar o problemă serioasă. Să o testezi la fiecare 15 secunde nu ajută pe nimeni. BreakDurationGenerator permite creșterea pauzei după fiecare test eșuat, după același principiu ca backoff-ul exponențial din articolul despre retry:
BreakDurationGenerator = args =>
{
    // 15s, 30s, 60s, 120s... maximum 5 minute
    double seconds = 15 * Math.Pow(2, args.HalfOpenAttempts);
    return ValueTask.FromResult(TimeSpan.FromSeconds(Math.Min(seconds, 300)));
}
Ordinea în pipeline: retry, apoi circuit breaker
În primul articol am văzut că ordinea strategiilor contează. Pentru retry și circuit breaker, ordinea corectă e aproape întotdeauna aceasta:
pipeline
    .AddTimeout(TimeSpan.FromSeconds(10))   // timeout total
    .AddRetry(retryOptions)                 // reîncearcă
    .AddCircuitBreaker(breakerOptions)      // vede FIECARE încercare
    .AddTimeout(TimeSpan.FromSeconds(2));   // timeout per încercare
Circuit breaker-ul stă în interiorul retry-ului, deci vede fiecare încercare individuală, inclusiv timeout-urile per încercare. Când circuitul se deschide, următoarea reîncercare primește instant BrokenCircuitException, în loc să mai plece pe rețea.
Aici apare o decizie importantă: retry-ul trebuie să reîncerce BrokenCircuitException? În general, nu. Un circuit deschis e un semnal explicit că dependența e jos pentru cel puțin câteva secunde. Să reîncerci după 500 ms înseamnă să primești aceeași excepție, doar mai târziu. Lasă BrokenCircuitException în afara predicatului ShouldHandle al retry-ului și tratează-o la apelant.
Ce faci când circuitul e deschis
Circuit breaker-ul nu rezolvă nimic singur. Doar transformă o așteptare lungă într-o eroare rapidă. Ce faci cu acea eroare e decizia ta de business:
public async Task<IReadOnlyList<Produs>> GetRecomandariAsync(int produsId, CancellationToken ct)
{
    try
    {
        return await _pipeline.ExecuteAsync(
            async token => await _client.GetRecomandariAsync(produsId, token), ct);
    }
    catch (BrokenCircuitException)
    {
        // Recomandările sunt opționale: checkout-ul merge mai departe fără ele
        return [];
    }
}
Pentru recomandări, răspunsul e simplu: carusel gol, checkout funcțional. Pentru o dependență critică, poate fi un răspuns 503 cu header Retry-After, o valoare din cache sau punerea operației într-o coadă. Toate aceste variante sunt subiectul articolului 5, despre graceful degradation. Ce contează acum e că decizia se ia în milisecunde, nu după 9 secunde.
Un breaker per dependență, nu unul global
Granularitatea circuit breaker-ului e o decizie de design la fel de importantă ca pragurile. Un singur breaker pentru toate apelurile externe ar însemna că o problemă la serviciul de recomandări blochează și plățile. Regula: un breaker per dependență, iar când o dependență are mai multe host-uri, per host.
Handler-ul standard din Microsoft.Extensions.Http.Resilience creează un pipeline per client HTTP. Dacă același client apelează mai multe host-uri, de exemplu un API regional pe mai multe domenii, poți separa pipeline-urile după authority:
builder.Services
    .AddHttpClient<IFurnizorClient, FurnizorClient>()
    .AddStandardResilienceHandler()
    .SelectPipelineByAuthority();
Astfel, api-eu.furnizor.example și api-us.furnizor.example au circuite independente. O problemă într-o regiune nu o blochează pe cealaltă.
Merită reținut și că starea circuit breaker-ului e locală fiecărei instanțe. Cu 10 poduri, ai 10 breaker-e care decid independent. De cele mai multe ori e exact ce vrei: fiecare instanță își observă propriul trafic. Un circuit breaker distribuit, sincronizat prin Redis, adaugă o dependență nouă exact în mecanismul care ar trebui să te protejeze de dependențe.
Control manual: ferestre de mentenanță
Uneori știi dinainte că o dependență va fi jos: furnizorul a anunțat mentenanță între 02:00 și 04:00. Nu are sens să aștepți ca breaker-ul să observe singur. Polly v8 permite deschiderea manuală a circuitului:
builder.Services.AddSingleton<CircuitBreakerManualControl>();

// în configurarea pipeline-ului:
ManualControl = context.ServiceProvider.GetRequiredService<CircuitBreakerManualControl>(),

// într-un endpoint de administrare sau un job programat:
await manualControl.IsolateAsync(ct);   // circuit forțat deschis
await manualControl.CloseAsync(ct);     // revenire la normal
Cât timp circuitul e izolat manual, apelurile primesc IsolatedCircuitException, o subclasă a BrokenCircuitException. Codul de tratare de mai sus funcționează fără nicio modificare.
Similar, CircuitBreakerStateProvider îți spune în orice moment starea curentă (Closed, Open, HalfOpen, Isolated). E tentant să-l legi direct de readiness probe-ul din Kubernetes. Nu face asta fără să citești articolul 4: dacă toate podurile își declară readiness-ul eșuat pentru că o dependență externă e jos, Kubernetes le scoate pe toate din load balancer, iar tu transformi o funcționalitate degradată într-o aplicație complet căzută.
Bulkhead: compartimente etanșe
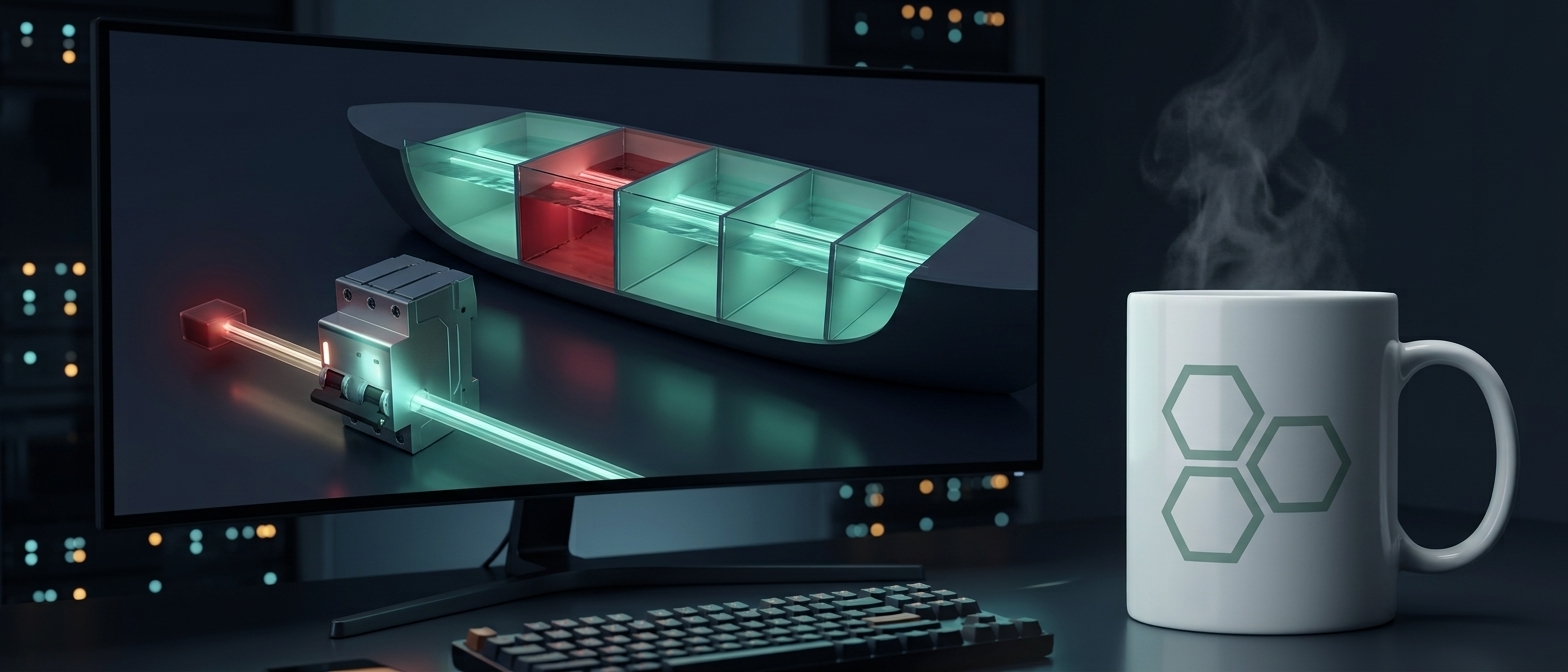
Numele vine din construcția navelor. Cala unui vapor e împărțită în compartimente etanșe. Dacă un compartiment ia apă, se inundă doar acela, iar nava rămâne pe linia de plutire. Titanicul s-a scufundat, printre altele, pentru că pereții etanși nu urcau până sus, iar apa a trecut dintr-un compartiment în altul.
În aplicații, „apa” e consumul de resurse. Fiecare apel în desfășurare către o dependență ține ocupată o conexiune HTTP, memorie pentru request și response, poate o conexiune din pool-ul SQL. Dacă o singură dependență lentă poate consuma toate aceste resurse, ea scufundă toată aplicația. Exact asta s-a întâmplat în povestea de la început.
Bulkhead-ul pune o limită pe numărul de apeluri simultane către o dependență. Dacă limita e atinsă, apelurile noi sunt respinse imediat sau așteaptă într-o coadă scurtă. Serviciul de recomandări poate avea maximum 20 de apeluri în desfășurare, iar al 21-lea primește o respingere instant. Plățile au propriul compartiment, neatins.
Bulkhead în Polly v8: concurrency limiter
În Polly v8, bulkhead-ul se implementează cu un concurrency limiter, construit peste System.Threading.RateLimiting:
dotnet add package Polly.RateLimitingbuilder.Services.AddResiliencePipeline<string, HttpResponseMessage>("recomandari", pipeline =>
{
pipeline
.AddConcurrencyLimiter(permitLimit: 20, queueLimit: 10)
.AddTimeout(TimeSpan.FromSeconds(10))
.AddRetry(retryOptions)
.AddCircuitBreaker(breakerOptions)
.AddTimeout(TimeSpan.FromSeconds(2));
});Maximum 20 de apeluri simultane, plus maximum 10 în așteptare. Al 31-lea apel primește RateLimiterRejectedException instant. Limiter-ul stă în exteriorul pipeline-ului, pentru că vrei să respingi cererea înainte să consume orice resursă, inclusiv timpul petrecut în reîncercări.
Handler-ul standard include deja un astfel de limiter, dar cu valori generoase: 1.000 de apeluri simultane, fără coadă. E o plasă de siguranță, nu un bulkhead reglat. Pentru dependențele care contează, ajustează-l:
.AddStandardResilienceHandler(options =>
{
    options.RateLimiter.DefaultRateLimiterOptions.PermitLimit = 20;
    options.RateLimiter.DefaultRateLimiterOptions.QueueLimit = 10;
});
Cum alegi limita
Legea lui Little, din primul articol, îți dă un punct de plecare. Dacă dependența primește 100 de cereri pe secundă și răspunde normal în 100 ms, ai în medie 10 apeluri simultane. O limită de 2–3 ori peste media normală, adică 20–30, lasă loc vârfurilor de trafic, dar oprește acumularea când latența explodează. La 8 secunde per răspuns, aceleași 100 de cereri pe secundă ar produce 800 de apeluri simultane. Cu bulkhead, rămân 20.
Bulkhead-uri care există deja
Merită să știi că aplicația ta are deja câteva compartimente, chiar dacă nu le-ai configurat explicit, iar unele sunt partajate, ceea ce le face periculoase:
- Pool-ul de conexiuni SQL Server are implicit maximum 100 de conexiuni (
Max Pool Size). E un bulkhead natural pentru baza de date, dar unul comun pentru toate query-urile. Un raport lent care ține 100 de conexiuni blochează și login-ul. SocketsHttpHandler.MaxConnectionsPerServere implicit nelimitat. Fără bulkhead, numărul de conexiuni către o dependență lentă crește fără limită.- Thread pool-ul e partajat de toată aplicația. Codul async corect nu ține thread-uri în așteptare, dar orice
.Resultsau.Wait()rătăcit transformă o dependență lentă într-o problemă de thread starvation.
Bulkhead pe intrare: rate limiting în ASP.NET Core
Până acum am protejat apelurile spre exterior. Același principiu funcționează și pe cererile care intră în aplicație. Middleware-ul de rate limiting din ASP.NET Core permite izolarea endpoint-urilor costisitoare, ca să nu consume resursele celor critice:
builder.Services.AddRateLimiter(options =>
{
    options.RejectionStatusCode = StatusCodes.Status503ServiceUnavailable;

    options.AddConcurrencyLimiter("rapoarte", limiter =>
    {
        limiter.PermitLimit = 5;
        limiter.QueueLimit = 10;
        limiter.QueueProcessingOrder = QueueProcessingOrder.OldestFirst;
    });
});

app.UseRateLimiter();

app.MapGet("/api/rapoarte/anual", GenereazaRaportAnual)
   .RequireRateLimiting("rapoarte");
Maximum 5 rapoarte anuale generate simultan, indiferent câți utilizatori apasă butonul. Restul aplicației, inclusiv emiterea facturilor, nu simte nimic.
Recapitulare
- Retry-ul tratează eșecuri scurte. Circuit breaker-ul tratează eșecuri persistente, oprind complet apelurile către o dependență bolnavă.
- Closed, Open, Half-Open: în Half-Open, un singur apel de test decide dacă circuitul se închide.
- În Polly v8, breaker-ul se bazează pe rata de eșec. Reglează
FailureRatio,MinimumThroughput,SamplingDurationșiBreakDurationdupă profilul real al dependenței. - Ordinea: timeout total, retry, circuit breaker, timeout per încercare. Nu reîncerca
BrokenCircuitException. - Un breaker per dependență și, unde e cazul, per host (
SelectPipelineByAuthority). CircuitBreakerManualControlpentru ferestre de mentenanță anunțate.- Bulkhead-ul limitează apelurile simultane per dependență, ca o singură problemă să nu consume resursele tuturor.
- Aplică același principiu și pe intrare, cu rate limiting-ul din ASP.NET Core.
Seria Reziliență în .NET
- Fundamente și Polly v8
- Retry policies inteligente
- Circuit breaker și bulkhead — articolul de față
- Health checks avansate
- Graceful degradation
- Chaos engineering basics
În articolul următor trecem de la ce face aplicația cu dependențele ei la cum își comunică propria stare: /health/live vs. /health/ready, startup probes și de ce o bază de date în liveness probe poate transforma o problemă minoră într-un restart în cascadă.